ENGINEERING NOTES
大模型推理基础(一):一次大模型推理是怎么完成的
什么是大模型
模型是一种从大量数据中学习规律,并根据输入预测输出的概率系统。
大模型的“大”,一方面体现在参数规模大。现代大模型的参数量通常以 B(Billion,十亿)为单位,一些模型甚至已经达到 T(Trillion,万亿)级别。例如 Kimi K 3 的总参数量达到了 2.8 T。
另一方面体现在计算规模大。无论是训练还是推理,大模型通常都需要消耗大量算力、显存和存储资源。
现代大模型的基本架构
现代大模型基本建立在 Transformer 架构之上。
传统 Transformer 由两个主要部分组成:
-
编码器(Encoder):负责对输入信息进行编码和表征。
-
解码器(Decoder):根据已有信息逐步生成输出。
目前主流的生成式大模型,例如 GPT、Qwen、DeepSeek 等,大多采用 仅解码器架构(Decoder-Only),也就是只使用 Transformer 的 Decoder 部分完成语言建模。
这类模型本质上属于一种因果语言模型(Causal Language Model)。
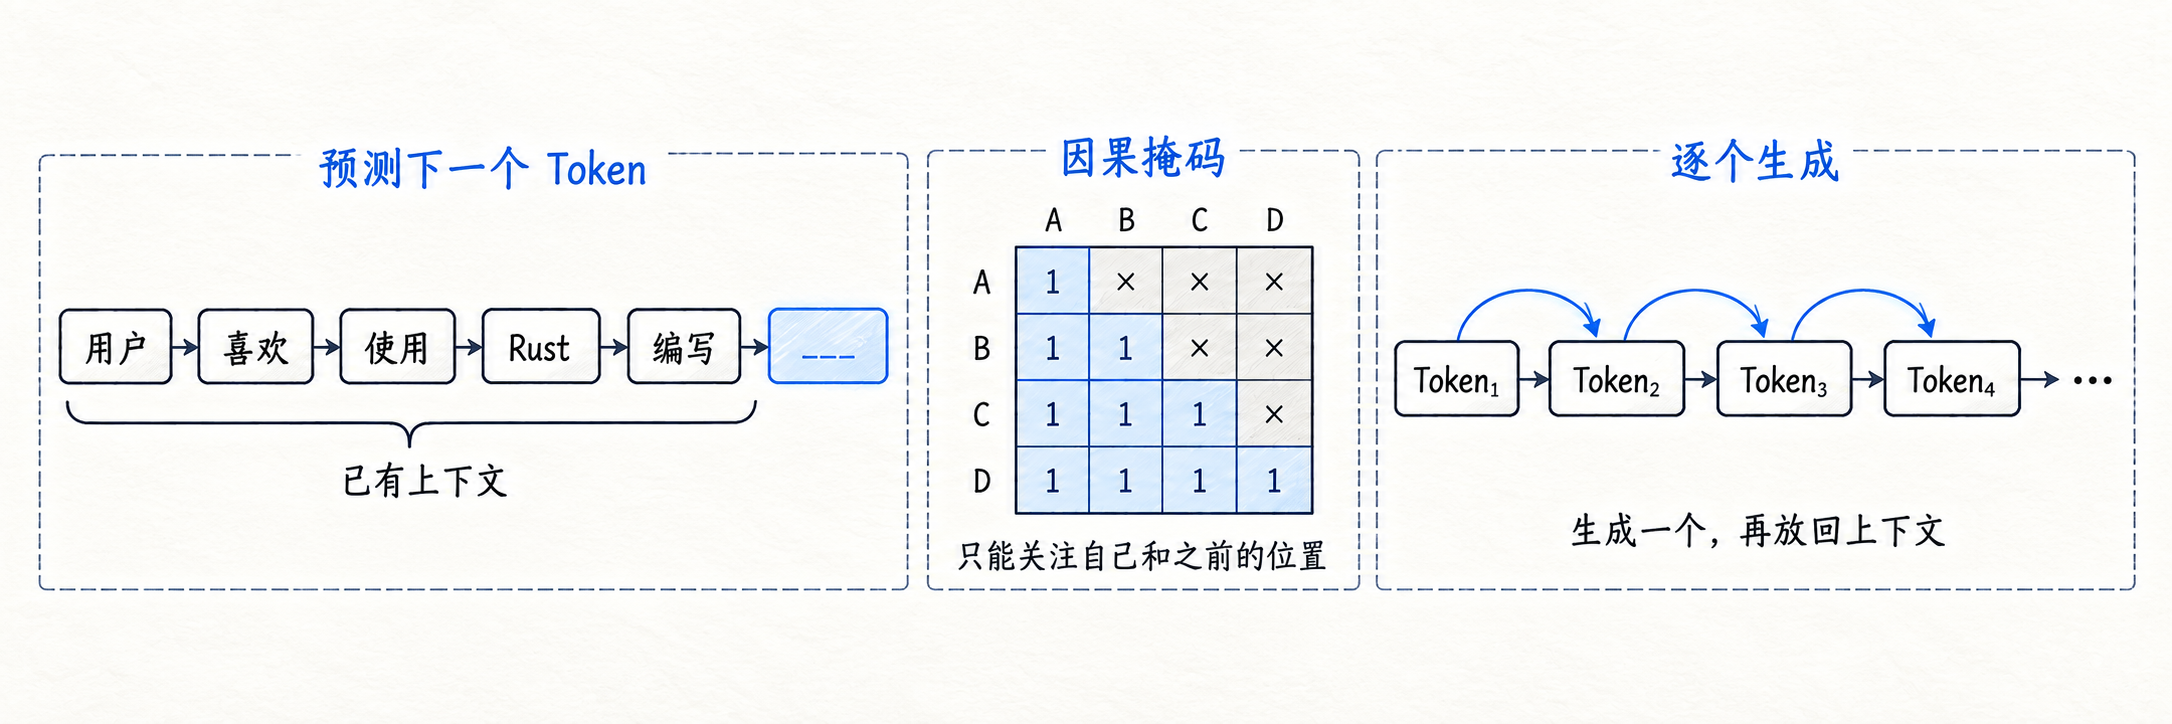
所谓“因果”,指的是模型在预测下一个 Token 时,只能够使用当前已经出现的 Token,而不能提前看到未来内容。
例如:
用户喜欢使用 Rust 编写 ___模型在预测空缺位置时,可以看到:
用户 → 喜欢 → 使用 → Rust → 编写但不能提前知道后面的正确答案。
这种限制通常通过 因果掩码(Causal Mask) 实现。
假设一段序列包含:
A B C D那么在进行注意力计算时:
A 只能看到 A
B 可以看到 A B
C 可以看到 A B C
D 可以看到 A B C D
也就是说,每个位置只能关注自己以及之前出现的内容,而无法看到未来 Token。
基于这种机制,大模型可以不断根据已有内容预测下一个 Token:
Token1 → Token2 → Token3 → Token4 → ...这种逐个预测并生成后续 Token 的方式,被称为自回归生成(Autoregressive Generation)。
从文本到模型输入
分词(Tokenization)
大模型并不能直接处理一整段自然语言。
在正式进入模型计算之前,需要先将文本拆分成一个个更小的单元,这些单元称为 Token,负责完成这一过程的组件称为 分词器(Tokenizer)。
例如:
今天天气不错
↓
["今天", "天气", "不错"]
这只是为了方便理解。
真实的分词器并不是简单按照固定字符数量进行切分,而是使用模型预先定义好的分词规则和词表。一个 Token 可能是一个汉字、一个单词、单词的一部分,也可能是标点符号等内容。
不同模型使用的分词器可能不同,因此同一句文本在不同模型中,可能会被拆分成不同数量的 Token。
模型仓库中通常会包含与分词器相关的配置文件。
例如 openbmb/MiniCPM5-2B 中可以看到:
-
tokenizer.json:保存分词器使用的词表及相关规则。 -
tokenizer_config.json:保存分词器的配置。
经过分词器处理之后,每个 Token 还会被映射到词表中的唯一编号,也就是 Token ID。
例如:
今天天气不错
↓
["今天", "天气", "不错"]
↓
[1234, 5678, 9012]
因此,从自然语言到 Token ID 的过程,可以简单理解为:
文本
↓
分词器
↓
Token
↓
Token ID这一整个过程通常称为分词(Tokenization),将文本转换为 Token ID 的过程也常被称为编码(Encoding)。
词嵌入(Embedding)
经过分词之后,我们已经得到了类似:
[1234, 5678, 9012]这样的 Token ID 序列。
但 Token ID 本身只是词表中的编号。
例如:
1234并不天然包含“今天”这个词的语义信息,模型也不能直接依靠编号之间的大小关系理解 Token。
因此,在进入 Transformer 之前,还需要经过词嵌入(Embedding),将每个 Token ID 映射成一个高维向量。
例如:
Token ID
↓
词嵌入(Embedding)
↓
[0.12, -0.37, 0.81, ...]
实际模型中的向量通常拥有数千甚至更多维度。
这些数字本身没有直接的人类语言含义,但在训练过程中,模型会逐渐学习如何使用这些向量表示不同 Token 的特征。
因此,前面的过程可以进一步表示为:
文本
↓
分词(Tokenization)
↓
Token IDs
↓
词嵌入(Embedding)
↓
高维向量
↓
Transformer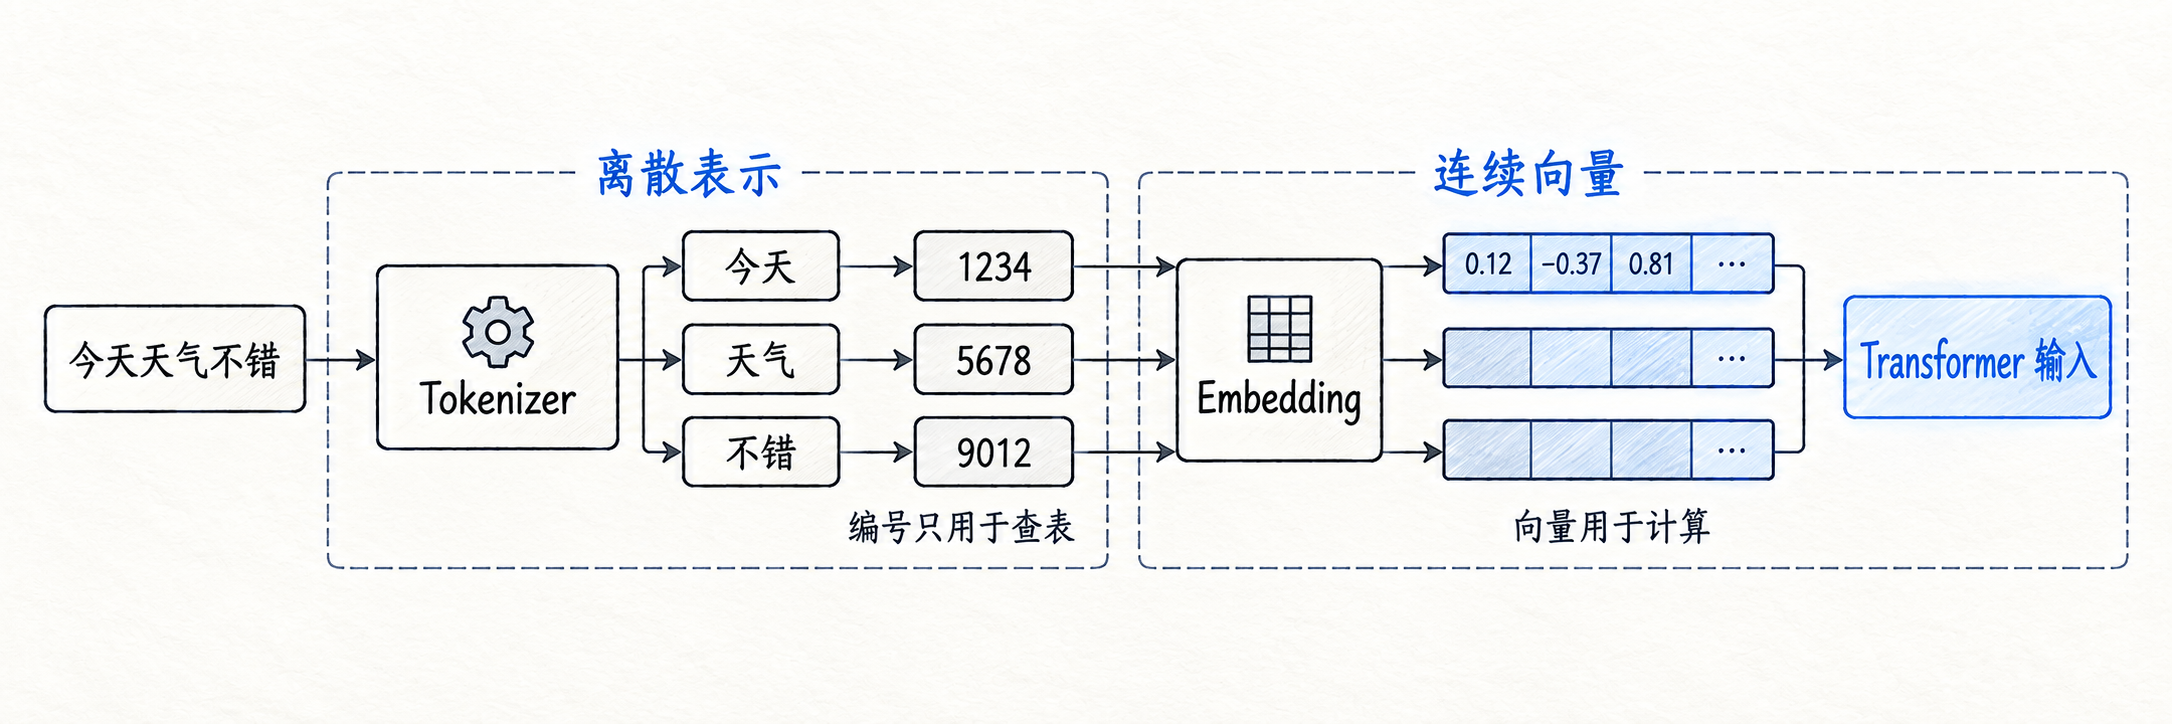
从这一刻开始,模型内部处理的就不再是文字或者 Token ID,而是一系列高维向量。
Transformer
经过词嵌入得到的向量,会进入多层 Transformer 进行计算。
Transformer 是现代大模型最核心的计算模块之一,它会结合当前上下文,对每个 Token 对应的向量不断进行计算和更新。
经过多层 Transformer 之后,每个 Token 都会得到新的向量表示,这些向量通常称为隐藏状态(Hidden State)。
这一过程可以暂时简化为:
词嵌入向量
↓
Transformer
↓
隐藏状态(Hidden State)
Transformer 内部还包含自注意力、残差连接、层归一化、前馈网络等多个重要组件。
这些内容会在下一篇单独展开。
在这一篇中,可以暂时将 Transformer 看成一个负责处理上下文和更新 Token 表示的黑盒。
输出层:从隐藏状态(Hidden State)到 Token
Token 经过多层 Transformer 计算之后,会得到对应的隐藏状态(Hidden State)。
可以简单理解为:
词嵌入表示 Token 刚刚进入模型时的向量,而隐藏状态则是 Token 在结合上下文并经过多层 Transformer 计算之后形成的向量表示。
对于文本生成而言,我们最关心的是序列最后一个位置对应的隐藏状态。
例如:
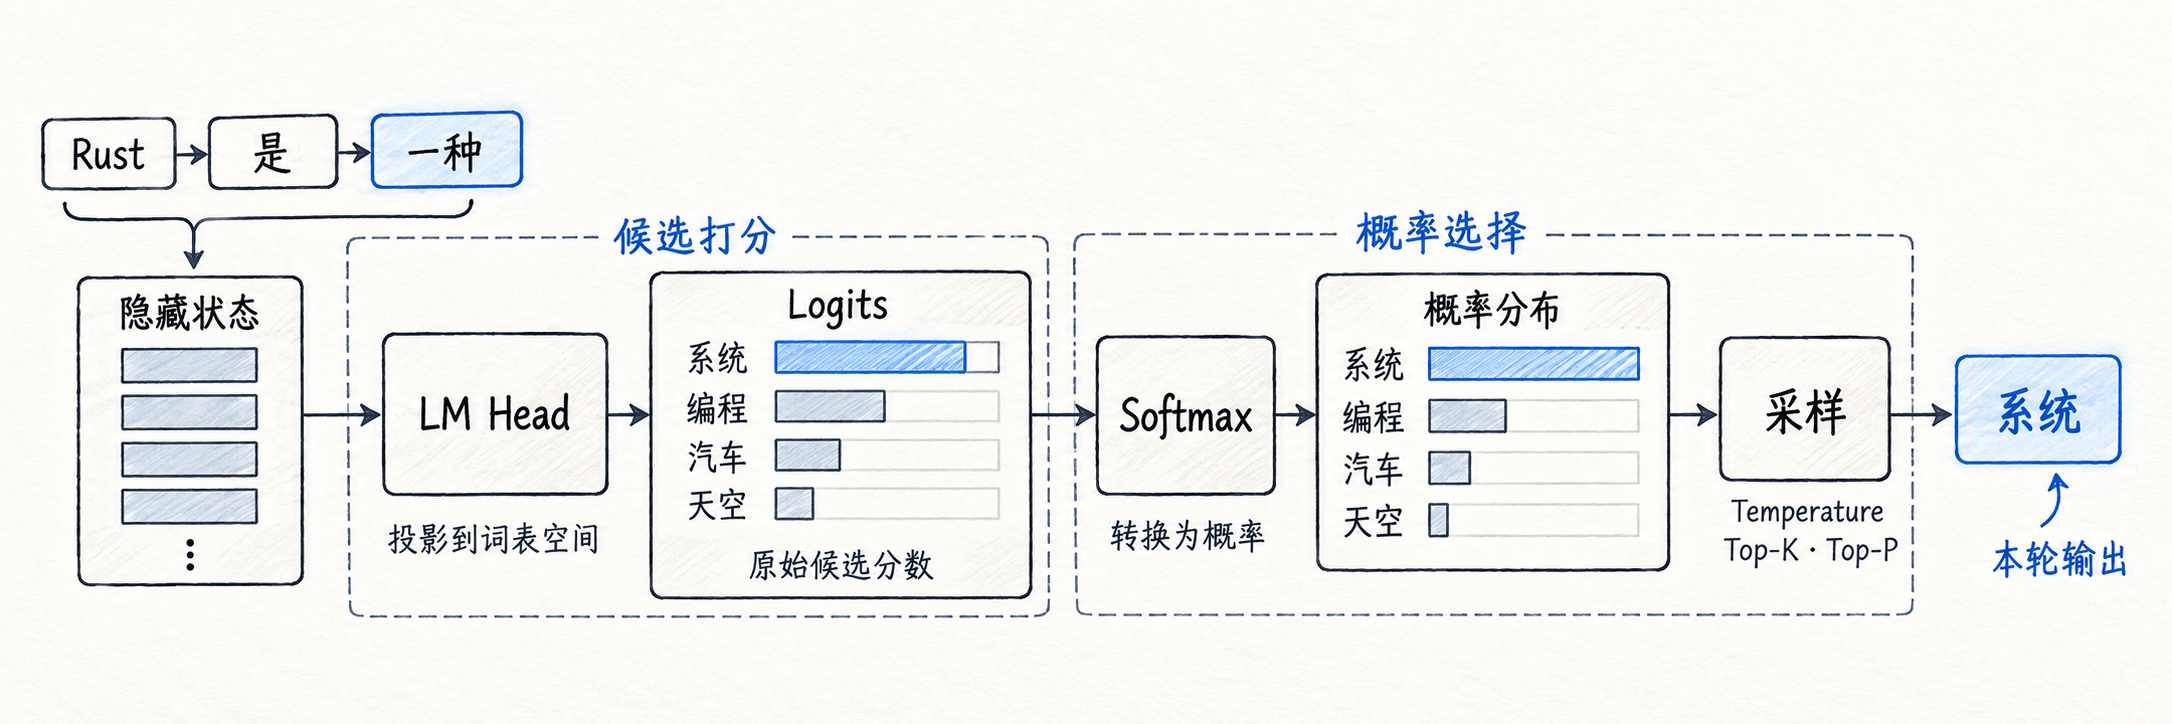
Rust 是一种 ___经过 Transformer 之后,可以简单理解为:
Rust → Hidden State
是   → Hidden State
一种 → Hidden State最后一个位置对应的隐藏状态,会继续进入语言模型头(LM Head)。
语言模型头的作用,是将隐藏状态从模型内部的向量空间映射到整个词表空间。
假设为了方便理解,模型的词表中只有四个 Token:
苹果
香蕉
汽车
天空
语言模型头可能得到:
苹果    8.2
香蕉    3.1
汽车   -1.2
天空    0.8
这些数值称为 Logits。
Logits 可以理解为模型对词表中每个 Token 给出的原始预测分数。
分数越高,通常意味着模型认为这个 Token 越适合作为下一个输出。
随后,Logits 会经过 Softmax 转换为概率分布,并结合温度(Temperature)、Top-K、Top-P 等采样策略,从候选 Token 中选择最终输出的 Token。
这一过程可以简单表示为:
隐藏状态(Hidden State)
↓
语言模型头(LM Head)
↓
Logits
↓
概率分布
↓
采样
↓
下一个 Token到这里,模型完成了一次下一个 Token 预测。
自回归生成(Autoregressive Generation)
一次完整的大模型回答,并不是一次计算直接生成整段文本。
模型每次只预测一个 Token。
假设用户输入:
Rust 是什么?模型第一次可能生成:
Rust然后将这个刚刚生成的 Token 加入已有上下文:
Rust 是什么? Rust再预测下一个 Token:
是上下文继续变成:
Rust 是什么? Rust 是然后再次预测:
一种于是整个生成过程可以表示为:
已有上下文
↓
预测下一个 Token
↓
将 Token 加入上下文
↓
再次预测下一个 Token
↓
将 Token 加入上下文
↓
...
最终可能逐渐形成:
Rust
↓
Rust 是
↓
Rust 是一种
↓
Rust 是一种系统
↓
Rust 是一种系统编程
↓
Rust 是一种系统编程语言这就是自回归生成(Autoregressive Generation)。
模型并不会在第一步就决定完整答案是什么,而是在已有上下文的基础上,不断预测下一个 Token。
因此,从生成机制来看,大模型最核心的工作可以概括成一句话:
根据当前已有的 Token,预测下一个 Token。
一次完整的大模型推理链路
现在可以把前面的内容全部串联起来。
用户首先输入自然语言:
Rust 是什么?文本先被转换成模型输入:
自然语言
↓
分词(Tokenization)
↓
Token
↓
Token IDs
↓
词嵌入(Embedding)
↓
高维向量
随后进入模型主体:
高维向量
↓
Transformer
↓
隐藏状态(Hidden State)
最后经过输出层完成预测:
隐藏状态(Hidden State)
↓
语言模型头(LM Head)
↓
Logits
↓
概率分布
↓
采样
↓
下一个 Token
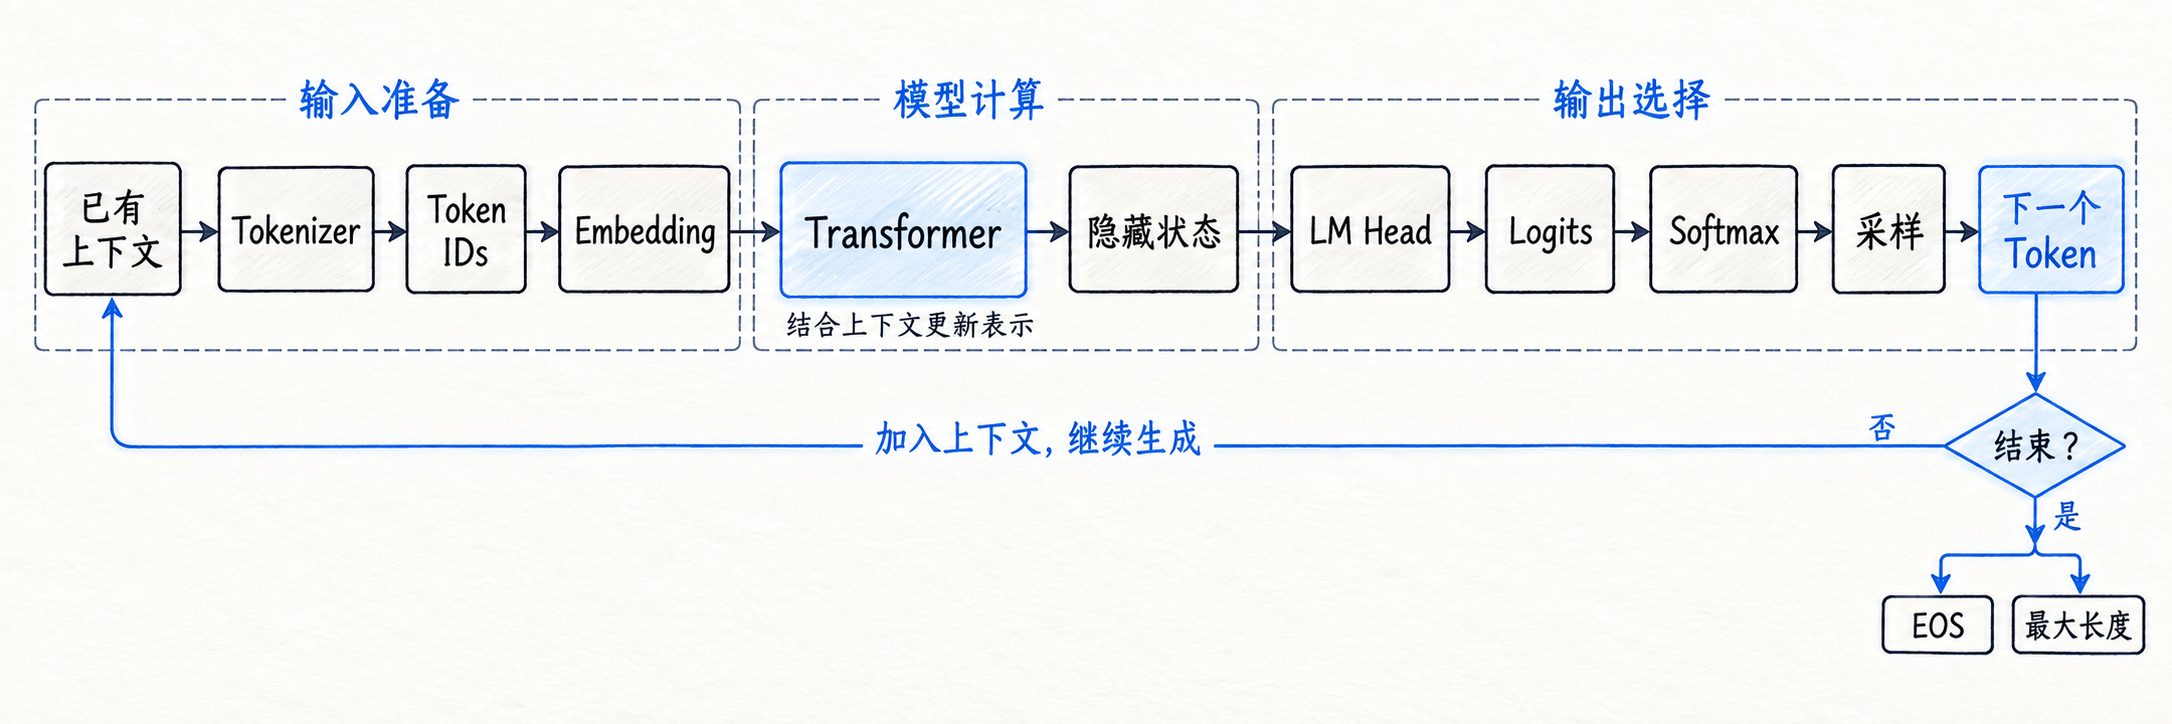
新生成的 Token 会被加入原来的上下文,然后再次参与下一次预测。
因此,一次完整的生成过程可以简化为:
自然语言
↓
分词(Tokenization)
↓
Token IDs
↓
词嵌入(Embedding)
↓
Transformer
↓
隐藏状态(Hidden State)
↓
语言模型头(LM Head)
↓
Logits
↓
采样
↓
下一个 Token
↓
加入上下文
↓
再次预测
↓
...
直到模型生成结束标记,或者达到最大输出长度,一次文本生成才真正结束。
总结
现代生成式大模型虽然拥有数十亿甚至万亿级参数,但如果暂时忽略内部复杂的数学计算,它的基本推理链路并不难理解:
自然语言
↓
分词(Tokenization)
↓
Token IDs
↓
词嵌入(Embedding)
↓
Transformer
↓
隐藏状态(Hidden State)
↓
语言模型头(LM Head)
↓
Logits
↓
采样
↓
下一个 Token
然后通过**自回归生成(Autoregressive Generation)**不断重复下一个 Token 的预测过程:
当前上下文
↓
预测下一个 Token
↓
加入上下文
↓
再次预测
因此,从生成机制来看,大模型的核心任务始终都是:
根据已有上下文预测下一个 Token。
理解这条主链路之后,就已经建立起了大模型推理最基本的心智模型。
不过到目前为止,我们仍然把 Transformer 当成了一个黑盒。
下一篇将打开这个黑盒,看看 Token 对应的向量进入 Transformer 之后,究竟经历了什么。